在cortex-皇冠最新app版本
在c run time library中,memcpy是重要的函数,对应用软件的性能有着重要的影响。arm芯片发展到cortex-a8[1][2]架构,不但频率有了很大提升,而且架构设计有了很大地改进。其中增加的neon指令,是类似于原先x86平台下的mmx指令,是为多媒体而设计。但因为这类指令一次可以处理64-bit数据,对memcpy函数性能提升也很有帮助。本文主要是测试采用neon[2]指令的多种memcpy实现,探讨neon指令和预取(preload)指令对性能的影响,以及在芯片优化和工艺进步后,这些影响的变化趋势。同时希望芯片设计人员在了解软件实现的基础上,给予一个知其然,也知其所以然的解释,进而指导进一步提高性能的方向。
本次的测试平台来源于笔者工作项目中接触到的cortex-a8平台。见下面列表:
- freescale i.mx51 / i.mx53
- qualcomm msm8x50 / msm7x30
- samsung s5pc100 / s5pc110
- ti omap 3430 / omap 3730
i.mx5 family
i.mx5 family的介绍见[6][7]。其中i.mx535可以运行在800mhz / 1000mhz两种频率上。
- i.mx515
- freq: 800mhz
- cache size: 32kb/32kb i/d cache and 256kb l2 cache
- cache line: 64-bit wide(neon), 64-byte / line
- i.mx535
- freq: 800mhz / 1000mhz
- cache size: 32kb/32kb i/d cache and 256kb l2 cache
- cache line: 64-bit wide(neon), 64-byte / line
snapdragon family
snapdragon的介绍见[8][9][10]。其中msm7x30可以运行在800mhz / 1000mhz两种频率上。此外snapdragon cache特别之处是128-bit wide(neon), 128-byte / line。标准cortex-a8中,该数值为64-bit wide(neon), 64-byte / line。这对性能有较大影响。
- msm8x50
- freq: 1000mhz
- cache size: 32kb/32kb i/d cache and 256kb l2 cache
- cache line: 128-bit wide(neon), 128-byte / line
- msm7x30
- freq: 800mhz / 1000mhz
- cache size: 32kb/32kb i/d cache and 256kb l2 cache
- cache line: 128-bit wide(neon), 128-byte / line
s5pc family
s5pc family参考平台见[11]。
- s5pc100
- freq: 665mhz
- cache size: 32kb/32kb i/d cache and 256kb l2 cache
- cache line: 64-bit wide(neon), 64-byte / line
- s5pc110
- freq: 1000mhz
- cache size: 32kb/32kb i/d cache and 512kb l2 cache
- cache line: 64-bit wide(neon), 64-byte / line
omap3 family
omap3 family参考平台见[12][13][14]。
- omap3430
- freq: 550mhz
- cache size: 16kb/16kb i/d cache and 256kb l2 cache
- cache line: 64-bit wide(neon), 64-byte / line
- omap3730
- freq: 1000mhz
- cache size: 32kb/32kb i/d cache and 256kb l2 cache
- cache line: 64-bit wide(neon), 64-byte / line
memcpy的实现在arm平台上的发展有3类版本:
- c语言版本
- arm汇编版本
- neon汇编版本
arm公司的文档[4]对memcpy的实现有很好描述。有人[5][19][20]还进一步阐述了实现原理和技巧。简述如下:
- neon指令一次可以处理64-bit数据,效率更高。
- neon架构与l1/l2 cache都有直连,在os层级enable后,可以获得更好的性能。
- arm / neon的pipeline有可能异步处理,交替使用arm / neon指令有可能获得更好的性能。
- 在一次循环中,用尽可能多的寄存器copy更多的数据,保证pipeline有更好的效率。目前一次最大处理块为128-byte。
- 对cache的操作有讲究。
- memcpy属于一次扫瞄无回溯的操作,对于cache采用预取(preload)策略可以提高hit rate。所以汇编版本中一定会使用pld指令提示arm预先把cache line填充好。
- pld指令中的offset很有讲究。一般为64-byte的倍数。在armv5te平台是一个循环用一个pld指令。在cortex-a8平台上速度更快,需要一个循环用2~3个pld指令填充cache line。这样一个循环消费2~3个时钟周期换得cache hit rate提高,效果是值得的。
- 进一步的,cortex-a8架构提供了preload engine指令,可以让软件更深地影响cache,以便让cache hit rate得到提高。不过要在用户空间使用ple指令,需要在os中打补丁开放权限。
c语言版本
c语言版本主要是做对比。采用两个实现:
- 32-bit wide copy。后面标记为in32_cpy。
- 16-byte wide copy。后面标记为vec_cpy。这个实现的技巧是采用gcc的向量扩展"__attribute__ ((vector_size(16)))",在c语言层级实现16-byte wide copy,将具体实现交给编译器。
值得注意的事情是,编译器不会主动插入pld指令。因为编译器无法判断应用对内存的访问模式。
arm汇编版本
arm汇编版本也主要是做对比。采用两个实现:
- siarhei siamashka实现[15]。后面标记为arm9_memcpy。他是为nokia n770做的优化。
- nicolas pitre实现[16]。后面标记为armv5te_memcpy。这是目前glibc里面缺省的arm memcpy实现。
neon汇编版本
neon汇编版本采用四个实现:
- m?ns rullg?rd实现[19]。这是一个128-byte-align block的最简单的实现。没有判断不是128-byte align的情况。因此不是实用的版本。但通过这类实现,可以考察memcpy性能的极限。他总共提供4种实现。
- 全arm汇编的实现。后面标记为memcpy_arm。此外,笔者还将其中的pld指令去掉,做为对比试验,考察pld指令的影响。后面标记为memcpy_arm_nopld。
- 全neon汇编的实现。后面标记为memcpy_neon。此外,笔者还将其中的pld指令去掉,做为对比试验,考察pld指令的影响。后面标记为memcpy_neon_nopld。
- arm / neon指令交替使用的实现。后面标记为memcpy_armneon。此外,笔者还将其中的pld指令去掉,做为对比试验,考察pld指令的影响。后面标记为memcpy_armneon_nopld。
- ple neon的实现。后面标记为memcpy_ple_neon。此外,笔者还将其中的neon指令换成arm指令,做为对比试验,考察ple指令对arm/neon指令的影响。后面标记为memcpy_ple_arm。因为这个实现需要对linux kernel打补丁,在omap3430平台上没有成功。在snapdragon平台上更换kernel有些麻烦,所以也没有测试。
- codesourcery实现[17]。这是codesourcery toolchain中的glibc里面的实现。也分两种实现。
- arm实现。后面标记为memcpy_arm_codesourcery。笔者还将其中的pld指令去掉,做为对比试验,考察pld指令的影响。后面标记为memcpy_arm_codesourcery_nopld。
- neon实现。后面标记为memcpy_neon_codesourcery。这也是android bionic里面采用的neon实现。笔者还将其中的pld指令去掉,做为对比试验,考察pld指令的影响。后面标记为memcpy_neon_codesourcery_nopld。
- qualcomm实现[18]。后面标记为memcpy_neon_qualcomm。这是qualcomm在code aurora forum中为snapdragon平台开发的优化版本。主要是对8660/8650a平台的优化。这个版本的特点是针对l2 cache line size=128bytes而设计,pld offset设置得特别大。结果在其它cortex-a8平台上没有效果。所以笔者将pld offset改为m?ns rullg?rd实现的数值。笔者还将其中的pld指令去掉,做为对比试验,考察pld指令的影响。后面标记为memcpy_neon_qualcomm_nopld。
- siarhei siamashka实现[20]。后面标记为memcpy_neon_siarhei。这是siarhei siamashka向glibc提交的neon版本,没有被glibc采纳。但是在maemo项目中得到采用。这个版本的特点是pld offset是从小到大增长的,以期望适应block size的变化。
测试方案十分简单。参考了movial memory tester的实现[21]。执行步骤如下:
- 先对每个实现进行正确性的验证。主要方法是以随机的block size & offset,填充随机的内容,然后执行memcpy操作,然后再用系统的memcmp函数对两块内存做校验。
- 然后对每个实现以不同的block size调用400次。如果total copy size < 1mb,则增加count直到满足要求。对总操作计时。
- 以total copy size / total copy time公式计算memcpy bandwidth。
上述提到的block size = 2^n ( 7 <= n <= 23 )。
此外,这个测试程序运行在openembedded-gpe软件系统中。qualcomm / samsung硬件平台只提供android软件系统,要更换到gpe系统有些麻烦,则采用chroot方式进行测试。不论是哪种软件平台,都是进入到图形系统后,静置,等待黑屏,然后再进行测试。
下表是运行环境的统计。
硬件平台
软件环境
imx51 800mhz
openembedded-gpe
imx53 1000mhz
openembedded-gpe
imx53 800mhz
openembedded-gpe
msm7230 1000mhz
android chroot
msm7230 800mhz
android chroot
msm8250 1000mhz
android chroot
omap3430 550mhz
openembedded-gpe
omap3730 1000mhz
openembedded-gpe
s5pc100 665mhz
android chroot
s5pc110 1000mhz
android chroot
下表是测试项目的统计。
实现方案
i.mx51
i.mx53
snapdragon
s5pc1xx
omap3430
omap3730
int32_cpy
yes
yes
yes
yes
yes
yes
vec_cpy
yes
yes
yes
yes
yes
yes
arm9_memcpy
yes
yes
yes
yes
yes
yes
armv5te_memcpy
yes
yes
yes
yes
yes
yes
memcpy_arm
yes
yes
yes
yes
yes
yes
memcpy_arm_nopld
yes
no
yes
yes
yes
yes
memcpy_neon
yes
yes
yes
yes
yes
yes
memcpy_neon_nopld
yes
no
yes
yes
yes
yes
memcpy_armneon
yes
yes
yes
yes
yes
yes
memcpy_ple_arm
yes
yes
n/a
yes
n/a
yes
memcpy_ple_neon
yes
yes
n/a
yes
n/a
yes
memcpy_arm_codesourcery
yes
yes
yes
yes
yes
yes
memcpy_arm_codesourcery_nopld
yes
no
yes
yes
yes
yes
memcpy_neon_codesourcery
yes
yes
yes
yes
yes
yes
memcpy_neon_codesourcery_nopld
yes
no
yes
yes
yes
yes
memcpy_neon_qualcomm
yes
yes
yes
yes
yes
yes
memcpy_neon_qualcomm_nopld
yes
no
yes
yes
yes
yes
memcpy_neon_siarhei
yes
yes
yes
yes
yes
yes
注1:因为i.mx53 evk板子发生故障,未能测试所有no pld的测试项。
注2:在给omap3430打开preload engine后,测试产生非法指令错,未能测试ple的测试项。
注3:要替换snapdragon kernel有些麻烦,未能测试ple的测试项。
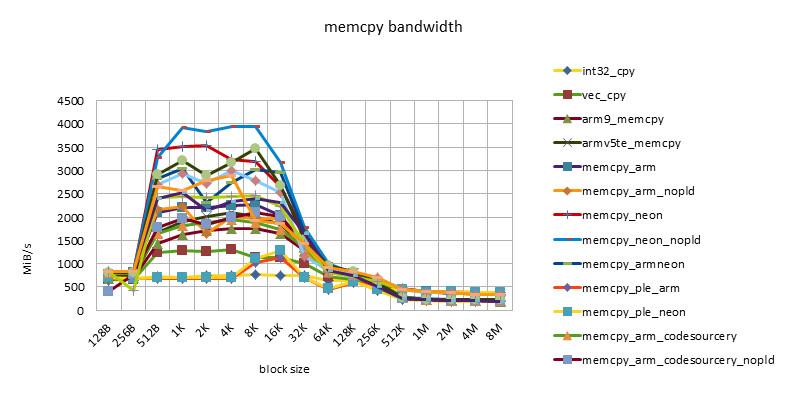
下面的图表限于页面大小不能很好地显示细节。具体的数据和大图可到数据表文档中查看。
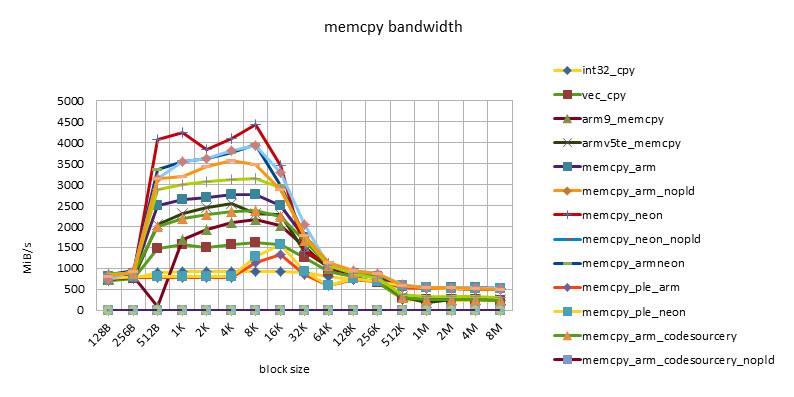
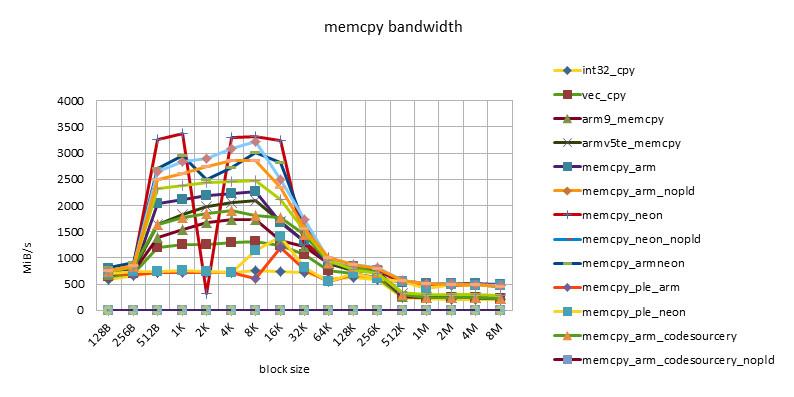
各个硬件平台上各种实现的表现
imx51 800mhz
imx53 1000mhz
imx53 800mhz
msm7230 1000mhz
msm7230 800mhz
msm8250 1000mhz
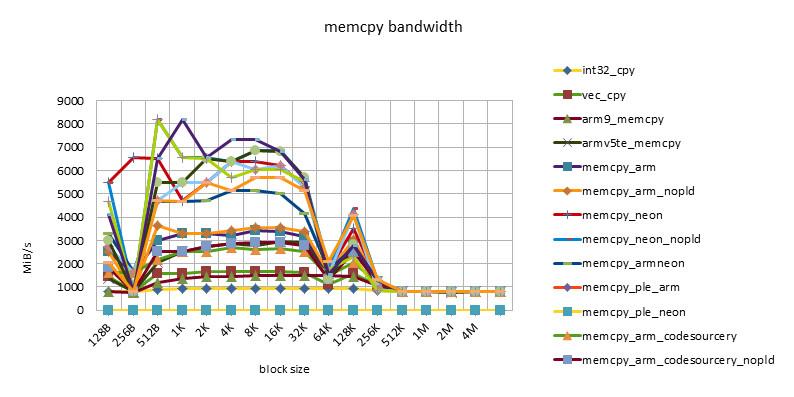
omap3430 550mhz
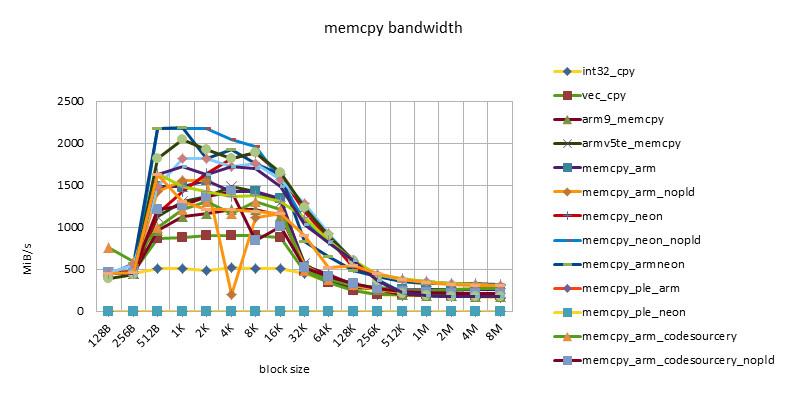
omap3730 1000mhz
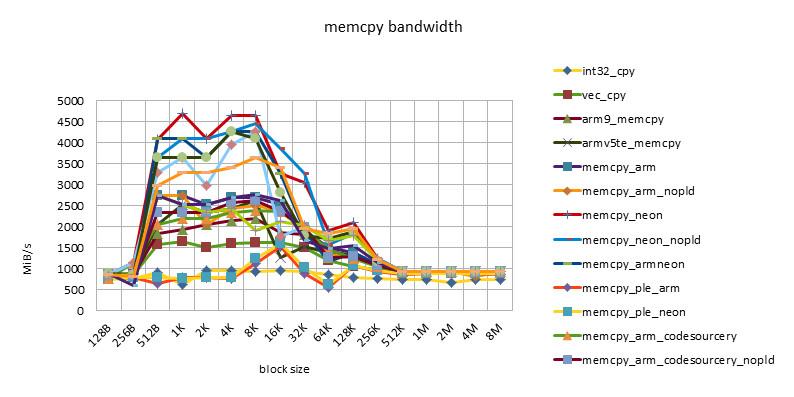
s5pc100 665mhz
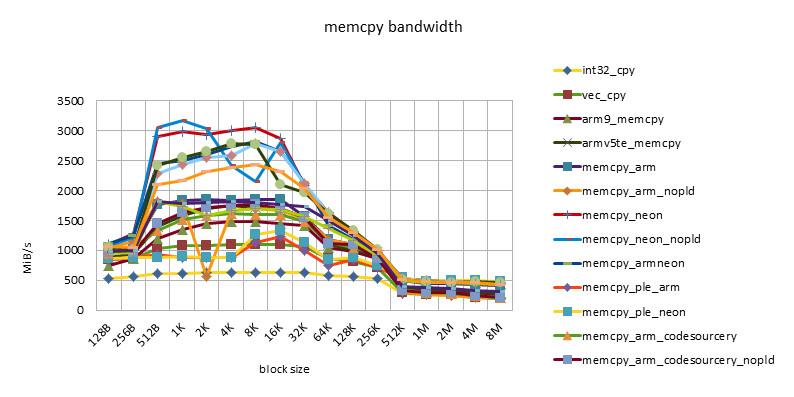
s5pc110 1000mhz
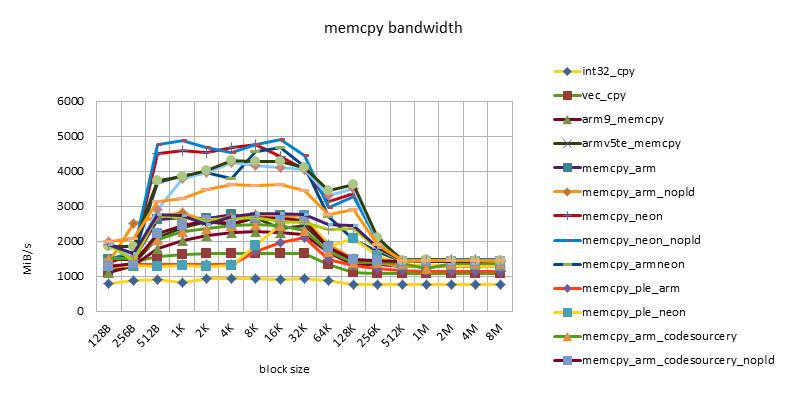
小结
- 在block size = 512b ~ 32k之间,有一个性能高台,block size = 256k也有一个性能的转折。
- 这个特性体现了32kb l1 / 256kb l2 cache的影响。
- 小于512b的性能不佳,可能与函数调用,函数开始的块对齐技巧造成的损耗有关,也可能与block size太小,cache没有准备好函数就结束了有关。
- 文档[]对memcpy的实现还是有指导意义的。但随着芯片内部的优化和工艺的提升,有些规则发生了变化。
- neon指令的性能总是要高于arm指令的性能。但交替使用arm/neon指令并不总是带来性能的提升。随着发展arm/neon指令之间性能差在缩小。
- pld指令的作用越来越小。在较老的芯片上,如omap3430,采用pld指令后,同一个实现可以有50%的性能提升。在较新的芯片上,如msm7230/s5pc110上,性能基本没有区别,甚至同一个实现没有pld指令后,性能稍稍有些提升。这也许是因为pld指令没有效果,倒反在每个循环中浪费了时钟周期造成的。
- 采用ple指令的实现的性能令人大失所望。这也说明如果没有很好的模型设计,软件去干预cache的使用,很容易会造成性能的恶化。
- snapdragon平台有最好的cache性能。超出cache后,各种实现(包括c语言实现)的性能基本一致,也很高效。这也许是snapdragon平台13-stage load/store pipeline[][]的设计造成的。这个特性对高级语言是有好处的。因为编程不可能在很多地方采用汇编语言。这样开发人员就不必过多地考虑汇编优化,依赖编译器就可以了。
- s5pc110平台有最好的平均性能。超出cache后,neon实现的性能最好,基本保持一条水平线。
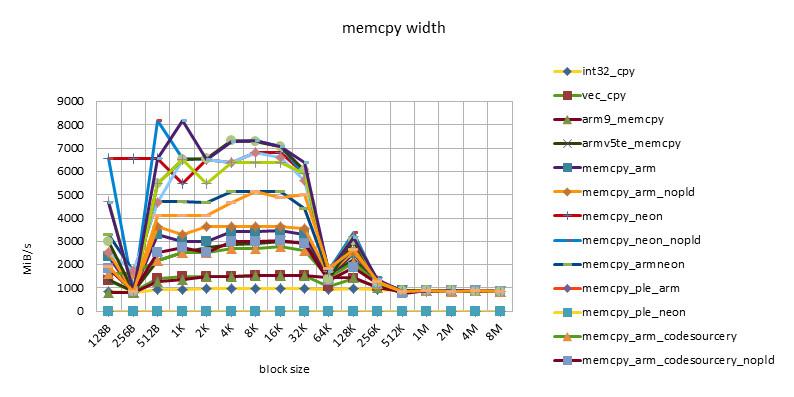
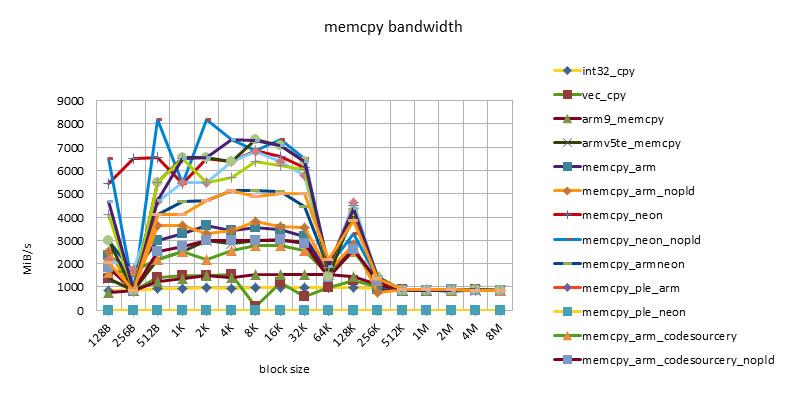
在small/big block size下各个硬件平台的表现
性能因为block size分为fit in cache / out of cache两种表现,所以做两个剖面做对比分析。
- 8k block size。体现fit in cache时的性能。
- 8m block size。体现out of cache时的性能。
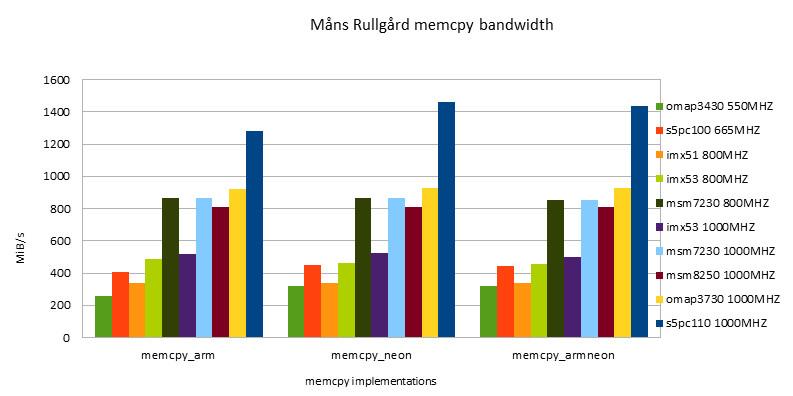
m?ns rullg?rd的实现
因为m?ns rullg?rd的实现最简单,除了一个循环体外,没有其它判断代码,可以认为是体现平台速度极限的实现。
arm的实现
neon的实现
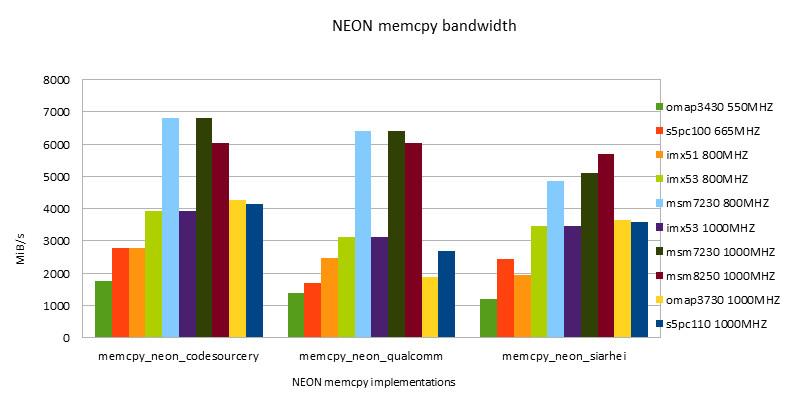
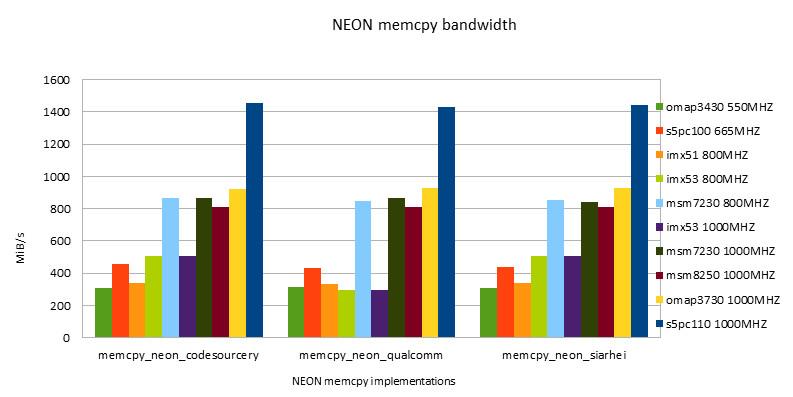
小结
- neon指令的性能总是要高于arm指令的性能。随着发展arm/neon指令之间性能差在缩小。
- 交替使用arm/neon指令,在fit in cache条件下性能要差于neon版本。在out of cache条件下,两个版本性能基本一样。
- 在fit in cache条件下,snapdragon平台有最好的性能。超过第二名s5pc110大约为43%。
- 在out of cache条件下,s5pc110有最好的性能。超过第二名omap3730大约为57%。
- 在同一个硬件平台下,超频(如i.mx53 800/1000mhz & msm7x30 800/1000mhz)对memory性能影响很小。
实用arm/neon实现在各个硬件平台的表现
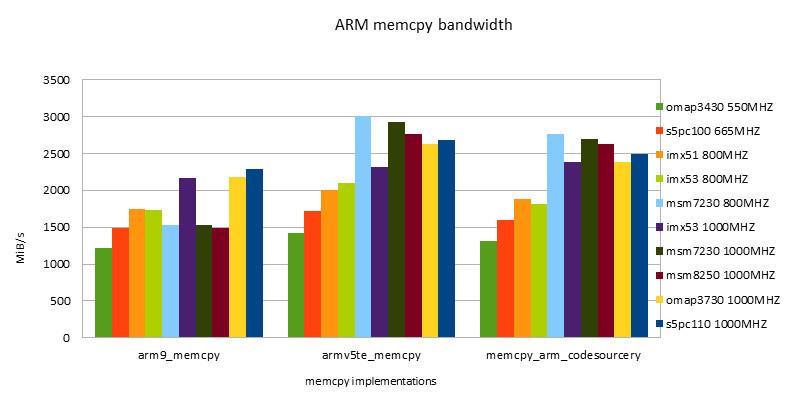
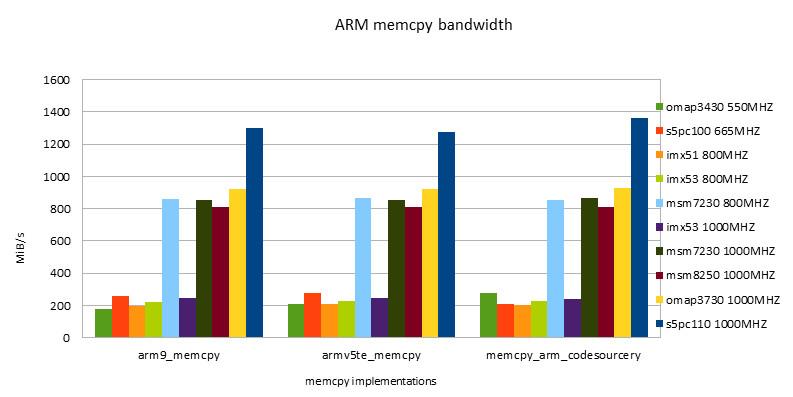
通过同一种实现在不同硬件平台上性能的对比,结合上一节的图表,可以评价一种实现的平均性能,也就是适应性。
arm的实现
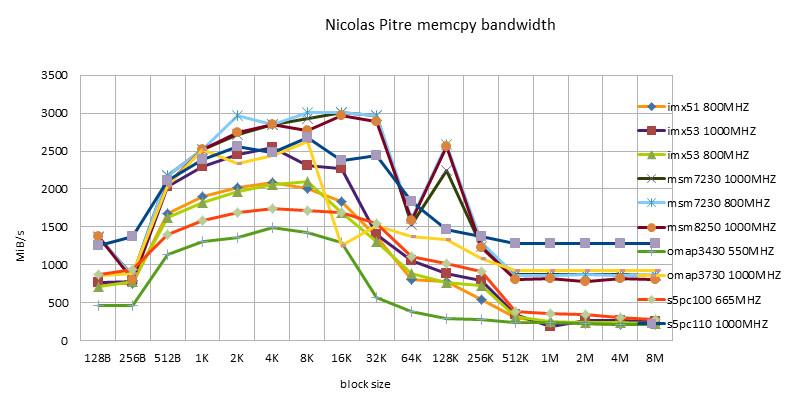
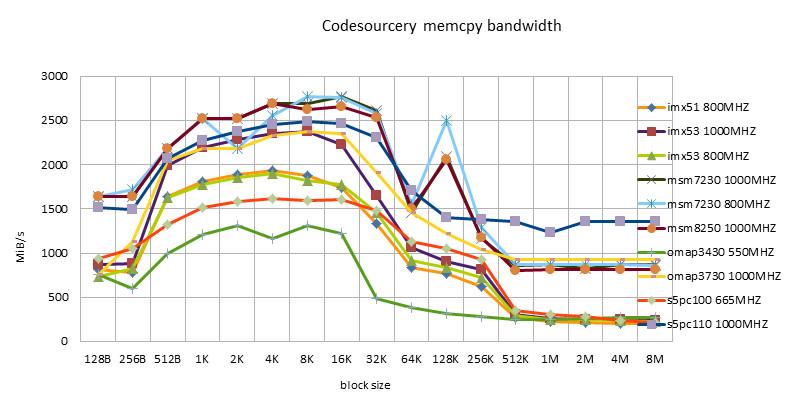
neon的实现
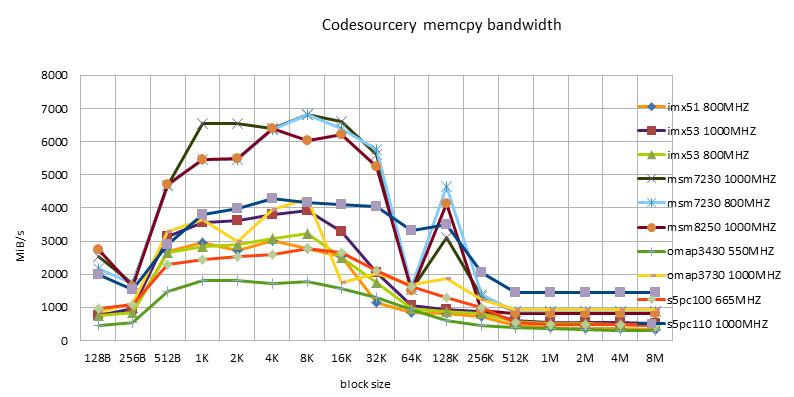
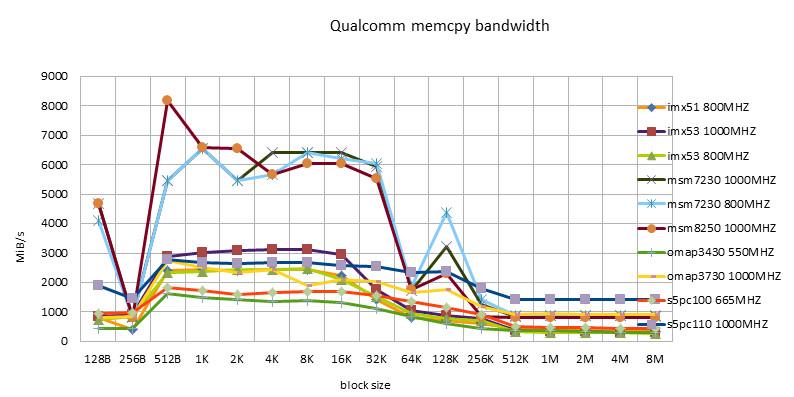
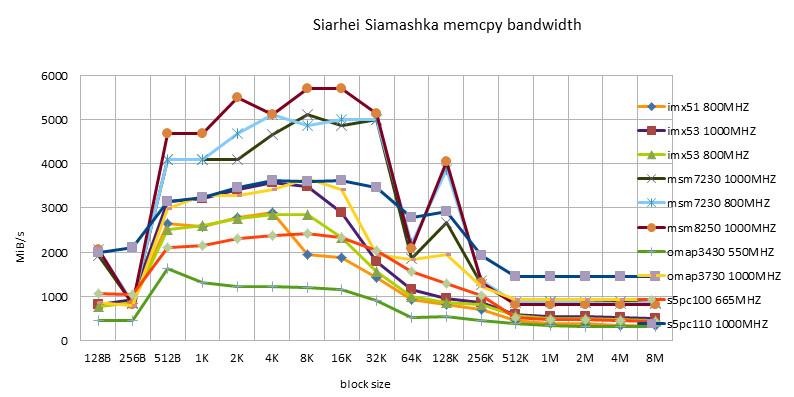
小结
- 同一种的实现,在不同的硬件平台上都有不同的表现。没有一种实现在所有平台上是最好的。
- codesourcery版本,包括arm/neon版本,有很好的适应性。不愧是做toolchain的公司。
- siarhei siamashka的neon版本也有很好的适应性。nokia的技术实力也很强。这哥们好像也是pixman项目里面做neon优化的主力。
- qualcomm版本只适合snapdragon平台。期待以后能在msm8660以及后续的芯片上进行测试。
- 在block size = 512b ~ 32k之间,有一个性能高台,block size = 256k也有一个性能的转折。这个特性体现了32kb l1 / 256kb l2 cache的影响。
- neon指令的性能总是要高于arm指令的性能。随着发展arm/neon指令之间性能差在缩小。交替使用arm/neon指令,性能往往要差于neon版本。
- 如果没有很好的模型设计,软件去干预cache的使用,很容易会造成性能的恶化。
- 在fit in cache条件下,snapdragon平台有最好的性能。
- 在out of cache条件下,s5pc110有最好的性能。
- 在同一个硬件平台下,超频对memory性能影响很小。
- 同一种的实现,在不同的硬件平台上都有不同的表现。没有一种实现在所有平台上是最好的。
因为在cortex-a8系列芯片里,neon模块是必有的。而在cortex-a9系列芯片里,neon模块是可选的。因为neon模块会影响到die size,因而影响功耗和成本。因此有些cortex-a9芯片,如nvidia tegra250,没带有neon模块。那么有无neon模块会对软件性能造成什么样的影响呢?




 热门文章